في محاولة واضحة لتهدئة غضب مجتمع المشتركين بعد قرارات القيود وتقليص الاستخدام الأخيرة، أعلنت Anthropic عن إطلاق Claude Fable 5.1. الشركة ركّزت في حملتها التسويقية على نقطة واحدة بتهم جيب كل مستخدم: الموديل الجديد أرخص بنسبة تصل إلى 40%.
السؤال الحقيقي اللي يهم أي حد بيشتغل بيه: هل التوفير ده حقيقي في التجربة العملية؟ وليه Anthropic بتتحرك في الاتجاه ده بالذات دلوقتي؟
1. ادعاء الـ 40% توفير: هل هو حقيقي؟
Anthropic قالت في إعلانها إن Fable 5.1 بيوفر لحد 40% من تكلفة التشغيل مقارنة بـ Fable 5.0.
من واقع تجربتنا واختباراتنا العملية في ماتريكس:
الكلام ده حقيقي فعلاً، بل وممكن يوفر أكتر من 40% لو فعّلت معمارية ذاكرة الوكلاء الفرعيين (Subagents Memory) والـ Prompt Caching.
السر هنا مش في تخفيض سعر التوكن المباشر، لكن في تخفيض استرجاع الكاش بنسبة 75% ($2.50 لكل مليون توكن بدل $10). لما بتشغل Agent بيعيد قراءة سياق المشروع باستمرار، الفاتورة بتنزل بشكل ملموس جداً.
2. سلوك الموديل في الشغل الحقيقي: بيحب الجلسات الطويلة
من واقع استخدامنا المكثف لـ Fable 5.1:
- الموديل بيعشق الجلسات الطويلة وسير العمل الضخم (Huge Workflows): هنا بالظبط بتظهر قوته الحقيقية وفارق أدائه عن باقي النماذج.
- في المشاريع المعقدة، ضبط الموديل على جهد استدلال متوسط (Medium) أو عالي (High) بيكون كافي جداً لإنجاز المطلوب بالكامل بدون ما يتشتت أو يسقط تفاصيل في ملفات الكود.
3. التحول الاستراتيجي: ليه Anthropic رايحة لعلوم الأحياء والبحث العلمي؟
بحسب آراء خبرائنا وتحليل تحركات السوق، Anthropic بتوجّه نفسها بوضوح لقيادة تصنيفات العلوم والبيولوجي (Science & Biology).
ليه؟ لأن المؤسسات البحثية وشركات الأدوية والعلوم سوق مضمون ومستقر وبيدفع عقود سنوية بالملايين، عكس مجتمع المبرمجين اللي ولائه متقلب وبيتنقل بين أداة والتانية كل أسبوعين.
في نفس الوقت، الشركات الأمريكية داخلة في صراع شرس مع الموديلات الصينية (زي GLM، DeepSeek، و Kimi) اللي الفجوة بينها وبين الموديلات الغربية بتضيق كل يوم بشكل يخوف.
نقطة إيجابية رصدها خبراؤنا: حواجز الأمان (Safeguards) في التحديث ده نزلت أهدى وأقل خنقاً للمستخدم. يبدو إن الإدارة الأمريكية بدأت تدرك أخيراً إن الإفراط في تقييد الشركات المحلية بالقوانين الصارمة هيخليهم يخسروا سباق الـ AI لصالح الصين.
4. تهديد تجاري حقيقي: المستخدمين بيهربوا من باقة الـ $200
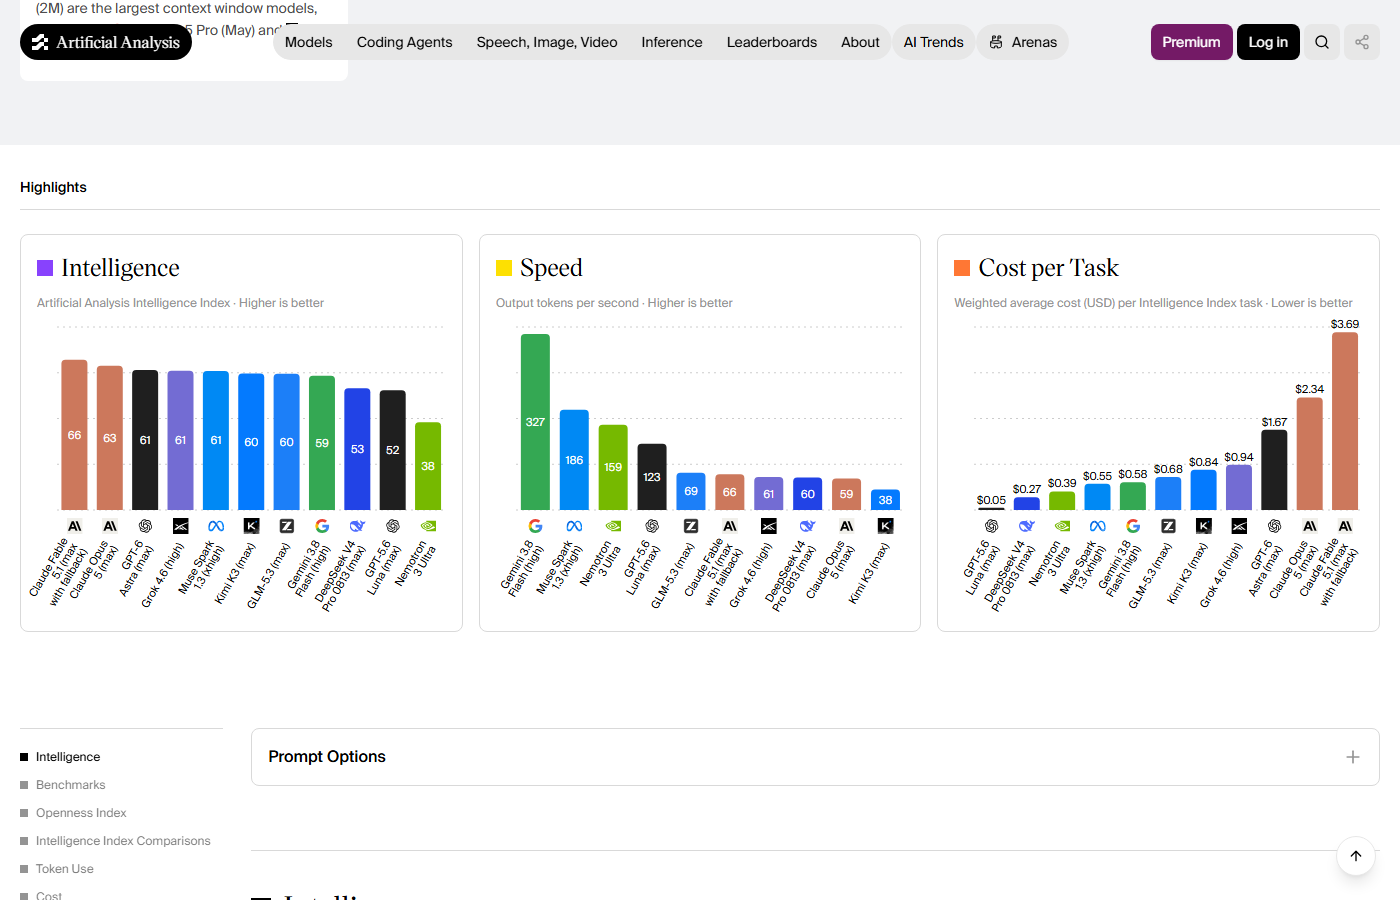
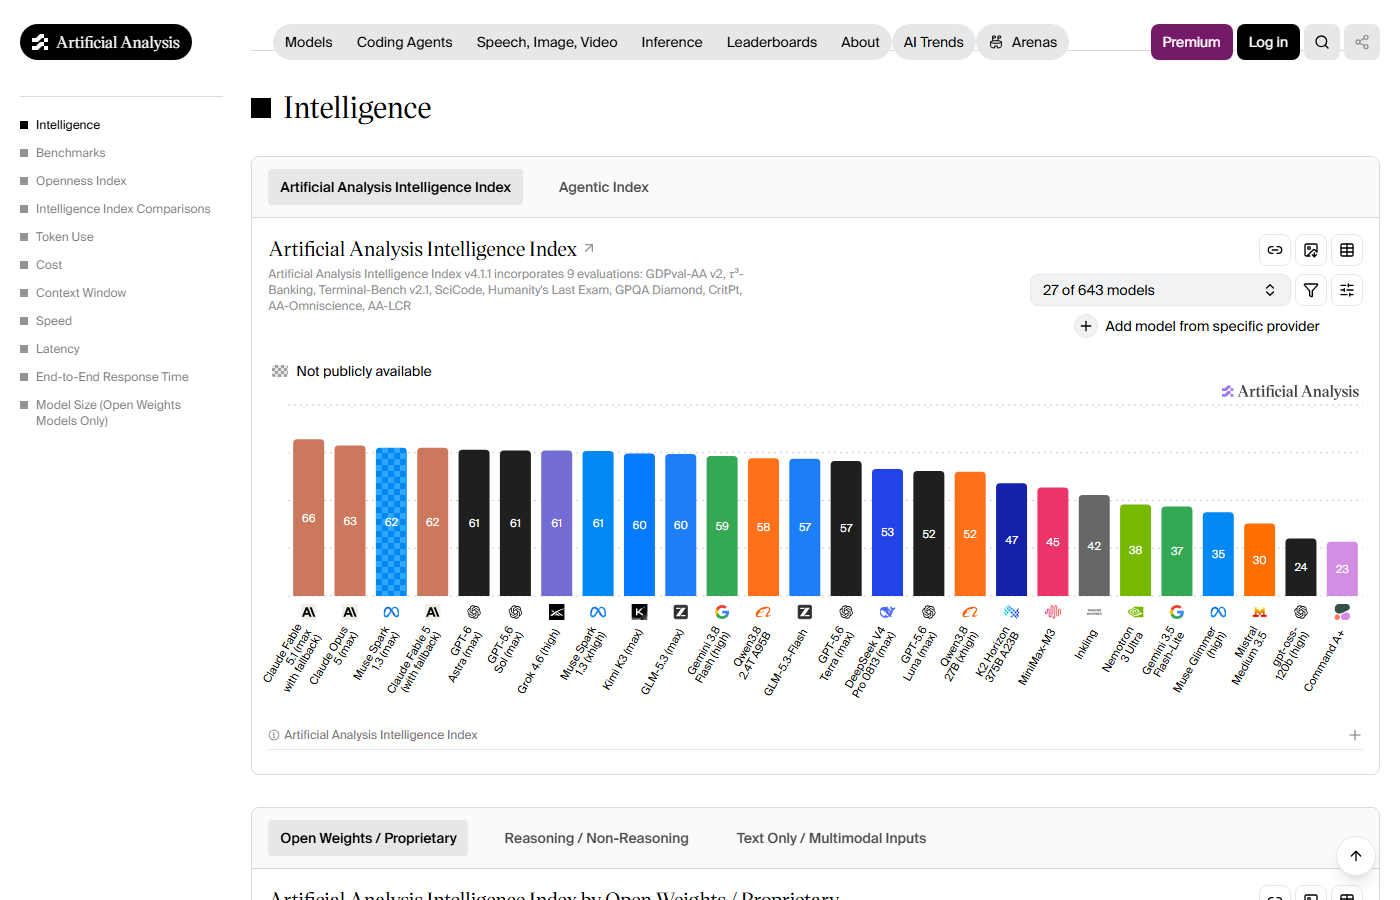
رغم إن الموديل محتل المركز الأول عالمياً في مؤشر الذكاء على Artificial Analysis بنتيجة 66 نقطة، إلا إن الشركة بتواجه أزمة حقيقية في الاشتراكات:
- قطاع واسع من المستخدمين بدأوا يلغوا اشتراك باقة الـ $200 (Max x20) وينزلوا لباقات الـ $100 أو $20، أو حتى التحول للدفع حسب الاستخدام على الـ API.
- النمط الجديد للمطورين: بقوا يستخدموا Claude حصرياً لـ وضع التخطيط (Planning Mode) وهندسة الحلول المعقدة فقط، وبعد ما الخطة تجهز، بياخدوا التنفيذ الروتيني لموديلات تانية أرخص أو مجانية.
المستخدمين بيشتكوا كمان من الضغط الأسبوعي؛ OpenAI مش ساكتة، وموديلات تانية بتقدم أداء مذهل ومجاني غير محدود زي GLM 5.3 Flash وإتاحة Ox Alpha للتجربة المجانية على مختلف المنصات، وده خلى الناس تسأل بجدية: هل Anthropic لسه قائدة السوق؟
نظرية مثيرة من أحد خبرائنا: فيه احتمال إن Anthropic بتخسر سباق المستخدمين العاديين عن عمد عشان تعظم أرباحها من عملاء الشركات الكبار (High Margin)، وفي نفس الوقت تخفف الحمل وتثبت استقرار مراكز البيانات (Data Centers) بتاعتها — رغم إنه مفيش دليل قاطع على النظرية دي لسه.
5. السؤال اللي الكل مستنيه: هل Fable 5.1 هيصمد قدام Astra؟
السؤال اللي فارض نفسه النهاردة: هل Fable 5.1 هيقدر يصمد قدام إطلاق Astra اللي أكدته OpenAI النهاردة؟
هل كانت OpenAI مستنية Anthropic تنزل Fable 5.1 الأول عشان تكشف عن موديل جيلها الجديد وتخطف الزخم قبل ما المستخدمين يغيروا خططهم؟
أيام قليلة ونعرف الإجابة.. خليك متابع معانا في ماتريكس عشان تعرف التحليل أول بأول!
المصادر والمراجع المعتمدة (Sources & References)
- إعلان Anthropic الرسمي وتوثيق الأسعار: Anthropic News & Model Card (September 2026)↗ — توثيق خصم 75% على الـ Prompt Caching ($2.50 لكل مليون توكن)، ومواصفات Fable 5.1 و Mythos 5.1.
- مؤشر البنشمارك العالمي: Artificial Analysis Intelligence Index & Speed Benchmark↗ — تسجيل Fable 5.1 للمركز الأول عالمياً بمؤشر ذكاء 66 نقطة، وسرعة 66 توكن/ثانية وتكلفة $3.69 للمهمة.
- تحليل تكاليف الحوسبة والشركات: VentureBeat: Anthropic Launches Claude Fable 5.1 and Mythos 5.1↗ — تفاصيل خفض تكلفة الحوسبة 25% وتوسيع استقرار نافذة السياق.
- توثيق أمان OpenAI وإعلان Astra: SecurityWeek & OpenAI Preparedness Framework↗ — الإعلان الرسمي عن تصنيف Astra في المستوى الحرج لاكتشاف ثغرات الـ Zero-Day.
- بيانات الاختبارات الحية لماتريكس: اختبارات مجتمع ومختبرات Matrix Growth Academy العملية على تشغيل الوكلاء متعددي الذاكرة (Subagents Memory) في بيئات الإنتاج البرمجي.
التعليقات (0)
0مفيش تعليقات لحد دلوقتي. كن أول واحد يشارك.